Site Web gratuit & Serveur Migration
Déployez des GPU NVIDIA H200 hautes performances
Exécutez des charges de travail d'IA exigeantes sur de puissants GPU NVIDIA H200 avec un déploiement rapide, infrastructures performantes, et un calcul cloud évolutif conçu pour les applications modernes d'apprentissage automatique.
- Optimisé pour l'IA & Charges de travail LLM
- Infrastructure GPU hautes performances
- Déploiement cloud évolutif
- Performances de calcul de niveau entreprise
À partir de
$2.30 par GPU / heure

Le bonheur de nos clients
Colonel est noté sur Google Avis
Colonel est noté sur Capterra
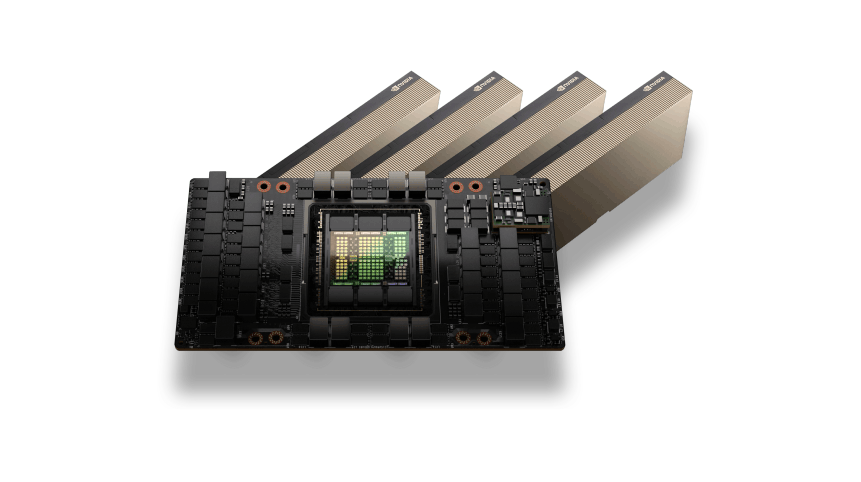
Architecture GPU NVIDIA H200
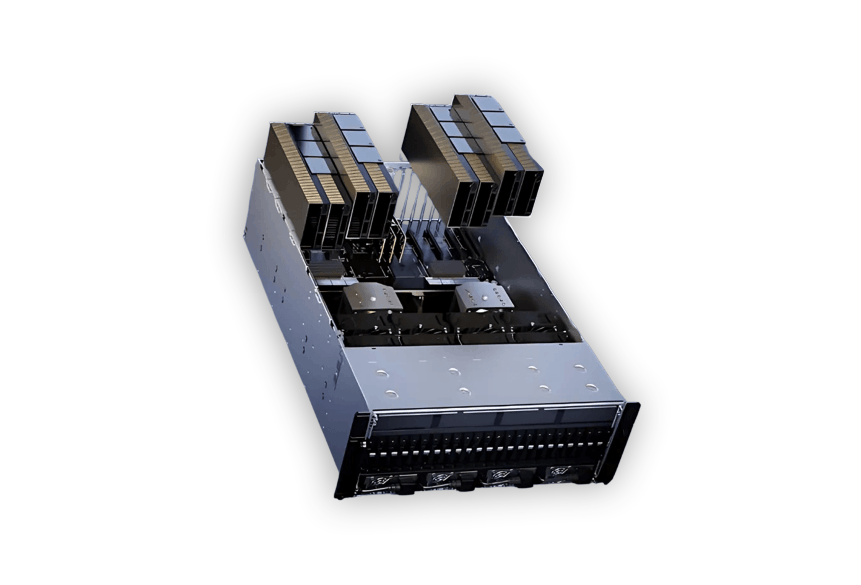
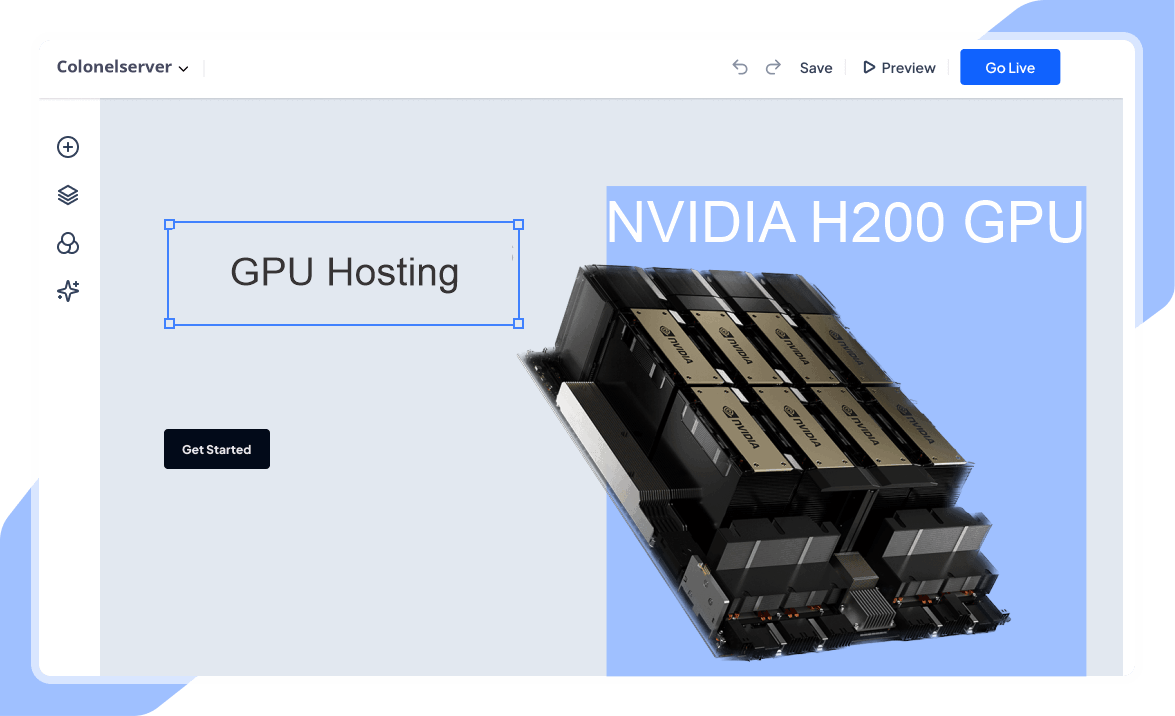
Le GPU NVIDIA H200 est construit sur l'architecture Hopper et offre des performances exceptionnelles pour les charges de travail d'IA modernes. Avec une capacité de mémoire HBM3e massive et une bande passante mémoire extrêmement élevée, Les GPU H200 sont conçus pour gérer de grands modèles de langage, formation en apprentissage profond, et tâches de calcul haute performance.
Performances de l'IA et du HPC
Les GPU NVIDIA H200 sont optimisés pour les environnements IA et HPC exigeants où de grands ensembles de données et des calculs complexes nécessitent une accélération puissante..
Qu'il s'agisse d'exécuter des pipelines de formation IA, Inférence LLM, ou simulations scientifiques, Les GPU H200 offrent les performances de calcul nécessaires pour traiter efficacement de grandes charges de travail tout en conservant une faible latence et une évolutivité élevée..
Cas d'utilisation des GPU NVIDIA H200
Formation sur les modèles d'IA
Entraînez des modèles de machine learning et de deep learning à grande échelle en utilisant la puissance de calcul massive des GPU NVIDIA H200.. Idéal pour la formation des modèles de transformateurs, réseaux de neurones, et de grands ensembles de données.
Inférence LLM
Déployer et exécuter de grands modèles de langage (LLM) tels que les modèles de style GPT, chatbots, et assistants IA avec inférence GPU hautes performances.
Calcul haute performance (HPC)
Accélérez les simulations scientifiques, charges de travail de recherche, et des tâches de calcul complexes qui nécessitent un traitement parallèle massif.
Traitement des données IA
Traiter et analyser de grands ensembles de données pour les pipelines d'IA, y compris le prétraitement, extraction de fonctionnalités, et analyse de données à grande échelle.
Rendu et simulation
Exécutez des charges de travail gourmandes en GPU telles que le rendu 3D, traitement vidéo, et des simulations physiques qui nécessitent un puissant calcul GPU parallèle.
Tarification flexible du GPU H200
GPU H200
Calcul GPU flexible à la demande pour la formation en IA, charges de travail d'inférence, et applications hautes performances.$2.30 par GPU / heure
Meilleur prixTop en vedette
Accélération du GPU NVIDIA H200
141Go de mémoire GPU HBM3e
Facturation horaire au fur et à mesure
Stockage NVMe hautes performances
Mise en réseau rapide de 10 à 100 Gbit/s
Idéal pour la formation et l'inférence en IA
Infrastructure cloud GPU évolutive
Déployer en quelques minutes
Optimisé pour les charges de travail LLM
Infrastructure GPU d'entreprise
Besoin d'une capacité GPU à grande échelle pour les clusters de formation d'IA ou les charges de travail d'entreprise?$ Tarification personnalisée
Pour les déploiements multi-GPU et les clusters dédiésTop en vedette
Clusters multi-GPU H200
Serveurs GPU dédiés
Processeur personnalisé, BÉLIER, et configurations de stockage
Infrastructure réseau GPU à haut débit
Conçu pour la formation en IA et les charges de travail HPC
Performances et fiabilité de niveau entreprise
Environnements de calcul IA évolutifs
Support technique prioritaire
Fonctionnalités d'entreprise des serveurs GPU NVIDIA H200
Performances extrêmes de formation en IA
Tirez parti de la puissance de calcul massive des GPU NVIDIA H200 pour former des modèles d'IA à grande échelle, réseaux de neurones profonds, et des charges de travail d'apprentissage automatique complexes avec une vitesse et une efficacité exceptionnelles.
Grande mémoire GPU HBM3e
Les GPU H200 fournissent une mémoire HBM3e haute capacité conçue pour les charges de travail d'IA exigeantes, grands modèles de langage, et pipelines de traitement de données hautes performances.
Optimisé pour les charges de travail LLM
Exécutez efficacement de grands modèles de langage modernes et des charges de travail d'inférence d'IA grâce à une architecture GPU optimisée pour les modèles de transformateur et les applications d'IA générative..
Infrastructure GPU haute vitesse
Our Serveurs GPU sont déployés sur une infrastructure haute performance avec un stockage NVMe et une mise en réseau rapide, garantissant une faible latence et des performances de calcul maximales.
Déploiement GPU évolutif
Faites évoluer facilement votre environnement de calcul d'une instance GPU unique à des charges de travail multi-GPU en fonction de vos exigences de formation en IA ou d'inférence..
Cloud flexible ou déploiement dédié
Choisissez entre des instances GPU cloud à la demande pour des charges de travail flexibles ou serveurs GPU dédiés pour les formations à long terme sur l'IA et les déploiements en entreprise.
Besoin d'aide pour choisir la bonne infrastructure GPU?
Questions fréquemment posées sur le serveur GPU
Trouvez des réponses aux questions courantes sur les serveurs GPU NVIDIA H200, options de déploiement, prix, et capacités de charge de travail de l'IA.

Chat en direct
24/7/365 Grâce au Chat Widget, important si vous exécutez.
L'hébergement GPU NVIDIA H200 fournit un calcul accéléré pour l'IA, grands modèles de langage, et applications gourmandes en mémoire. Choisissez une configuration de serveur en fonction de la taille de votre modèle et de votre charge de travail.
Les serveurs H200 peuvent prendre en charge l'apprentissage profond, inférence grand modèle, calcul scientifique, et autres applications compatibles accélérées par GPU. Les performances réelles dépendent de la configuration du logiciel et de la charge de travail.
La mémoire GPU contient les poids des modèles et les données de travail. Modèles plus grands, des lots plus gros, et les contextes plus longs augmentent les besoins en mémoire, donc estimez ces besoins avant de sélectionner un serveur.
Vous pouvez utiliser des frameworks compatibles GPU avec un pilote NVIDIA approprié et une pile logicielle CUDA. Vérifiez la version du framework et les exigences de l'image de déploiement avant l'installation.
No. Des modèles et des tâches de développement plus petits peuvent s'adapter à d'autres options de GPU. Comparez les besoins en mémoire, performance mesurée, et les coûts de fonctionnement pour choisir le matériel approprié.
Examinez la configuration GPU disponible, RAM système, Processeur, stockage, allocation réseau, et conditions de facturation. Faites correspondre ces ressources à votre application et à l'utilisation prévue.
Adaptez la mémoire GPU à votre modèle ou à votre charge de travail de rendu, puis autorisez suffisamment de RAM système, Processeur, et stockage pour la préparation des données et les processus de candidature. Testez les charges de travail représentatives avant de les mettre à l’échelle.
Le rendu accéléré par GPU est possible avec un logiciel compatible. Confirmez la prise en charge de votre modèle de GPU, version du pilote, système opérateur, et licence d'application avant le déploiement.
Oui. Conserver des copies indépendantes des ensembles de données, code, configuration, et modèles de points de contrôle. Les ressources de calcul GPU ne remplacent pas un plan de sauvegarde et de récupération.
Confirmer la disponibilité du GPU, compatibilité des pilotes et du framework, capacité de stockage, termes du réseau, et conditions de facturation. Choisissez une configuration adaptée à votre charge de travail et testez-la avant utilisation en production.