Language & currency
Currency

Kostenlose Website & Server Migration

Oberst Server

Stellen Sie leistungsstarke NVIDIA H200-GPUs bereit

Führen Sie anspruchsvolle KI-Workloads auf leistungsstarken NVIDIA H200-GPUs mit schneller Bereitstellung aus, Hochleistungsinfrastruktur, und skalierbares Cloud-Computing, das für moderne maschinelle Lernanwendungen entwickelt wurde.

Beginnend bei

$2.30 pro GPU / Stunde

Europe H200 GPU hosting service
shape 2

Unsere Kundenzufriedenheit
img 47

Oberst bewertet wird auf Google Review
img 48

Oberst bewertet wird auf Capterra

NVIDIA H200 GPU-Architektur

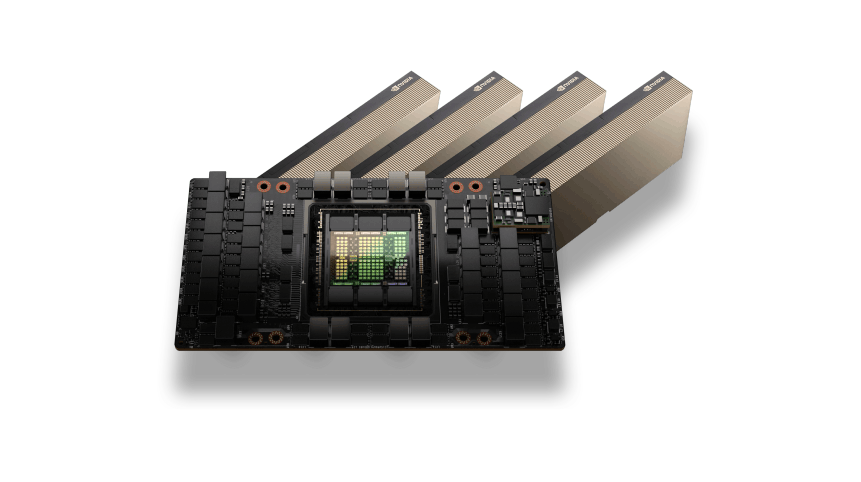
Die NVIDIA H200 GPU basiert auf der Hopper-Architektur und liefert außergewöhnliche Leistung für moderne KI-Workloads. Mit enormer HBM3e-Speicherkapazität und extrem hoher Speicherbandbreite, H200-GPUs sind für die Verarbeitung großer Sprachmodelle ausgelegt, Deep-Learning-Training, und Hochleistungsrechneraufgaben.

gpu feature cloud as a service
gpu cluster feature cloud as a service

KI- und HPC-Leistung

NVIDIA H200-GPUs sind für anspruchsvolle KI- und HPC-Umgebungen optimiert, in denen große Datensätze und komplexe Berechnungen eine leistungsstarke Beschleunigung erfordern.

Ob Sie KI-Trainingspipelines betreiben, LLM-Schlussfolgerung, oder wissenschaftliche Simulationen, H200-GPUs bieten die erforderliche Rechenleistung, um große Arbeitslasten effizient zu verarbeiten und gleichzeitig eine geringe Latenz und hohe Skalierbarkeit aufrechtzuerhalten.

Anwendungsfälle für NVIDIA H200-GPUs

KI-Modelltraining

Trainieren Sie groß angelegte Modelle für maschinelles Lernen und Deep Learning mit der enormen Rechenleistung der NVIDIA H200-GPUs. Ideal zum Trainieren von Transformatormodellen, neuronale Netze, und große Datensätze.

LLM-Inferenz

Stellen Sie große Sprachmodelle bereit und führen Sie sie aus (LLMs) wie zum Beispiel Modelle im GPT-Stil, Chatbots, und KI-Assistenten mit leistungsstarker GPU-Inferenz.

Hochleistungsrechnen (HPC)

Beschleunigen Sie wissenschaftliche Simulationen, Forschungsarbeitsbelastungen, und komplexe Rechenaufgaben, die eine massive Parallelverarbeitung erfordern.

KI-Datenverarbeitung

Verarbeiten und analysieren Sie große Datensätze für KI-Pipelines, inklusive Vorverarbeitung, Merkmalsextraktion, und groß angelegte Datenanalysen.

Rendering und Simulation

Führen Sie GPU-intensive Arbeitslasten wie 3D-Rendering aus, Videoverarbeitung, und Physiksimulationen, die leistungsstarkes paralleles GPU-Computing erfordern.

Flexible H200-GPU-Preise

GPU-Infrastruktur für Unternehmen

Benötigen Sie große GPU-Kapazität für KI-Trainingscluster oder Unternehmens-Workloads?

$ Individuelle Preise

Für Multi-GPU-Bereitstellungen und dedizierte Cluster
image

Top vorgestellt

Multi-GPU-H200-Cluster

Dedizierte GPU-Server

Benutzerdefinierte CPU, RAM, und Speicherkonfigurationen

Hochgeschwindigkeits-GPU-Netzwerkinfrastruktur

Entwickelt für KI-Schulungen und HPC-Workloads

Leistung und Zuverlässigkeit auf Unternehmensniveau

Skalierbare KI-Rechenumgebungen

Vorrangiger technischer Support

Fordern Sie eine benutzerdefinierte GPU-Bereitstellung an

Unternehmensfunktionen von NVIDIA H200 GPU-Servern

icon 01

Extreme KI-Trainingsleistung

Nutzen Sie die enorme Rechenleistung der NVIDIA H200-GPUs, um umfangreiche KI-Modelle zu trainieren, tiefe neuronale Netze, und komplexe maschinelle Lernaufgaben mit außergewöhnlicher Geschwindigkeit und Effizienz.

icon 02

Großer HBM3e-GPU-Speicher

H200-GPUs bieten HBM3e-Speicher mit hoher Kapazität, der für anspruchsvolle KI-Workloads ausgelegt ist, große Sprachmodelle, und leistungsstarke Datenverarbeitungspipelines.

icon 03

Optimiert für LLM-Workloads

Führen Sie moderne große Sprachmodelle und KI-Inferenz-Workloads effizient mit einer GPU-Architektur aus, die für Transformatormodelle und generative KI-Anwendungen optimiert ist.

icon 04

Hochgeschwindigkeits-GPU-Infrastruktur

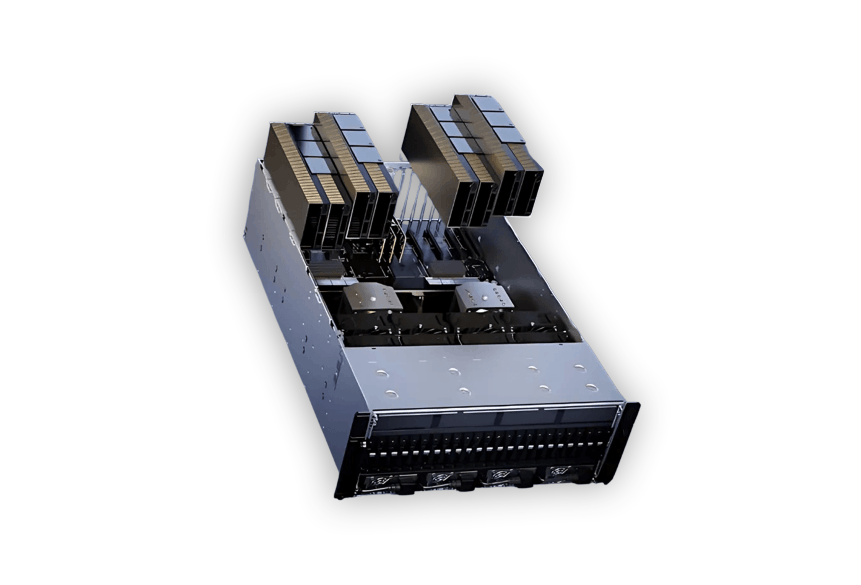
Unser GPU-Server werden auf einer leistungsstarken Infrastruktur mit NVMe-Speicher und schneller Vernetzung bereitgestellt, Gewährleistung geringer Latenz und maximaler Rechenleistung.

icon 05

Skalierbare GPU-Bereitstellung

Skalieren Sie Ihre Rechenumgebung ganz einfach von einer einzelnen GPU-Instanz auf Workloads mit mehreren GPUs, abhängig von Ihren KI-Trainings- oder Inferenzanforderungen.

icon 06

Flexible Cloud- oder dedizierte Bereitstellung

Wählen Sie zwischen On-Demand-Cloud-GPU-Instanzen für flexible Arbeitslasten oder dedizierte GPU-Server für langfristige KI-Schulungen und Unternehmensbereitstellungen.

Benötigen Sie Hilfe bei der Auswahl der richtigen GPU-Infrastruktur??

Häufig gestellte Fragen zum GPU-Server

Finden Sie Antworten auf häufig gestellte Fragen zu NVIDIA H200 GPU-Servern, Bereitstellungsoptionen, Preisgestaltung, und KI-Workload-Funktionen.

icon img 2

Live-Chat

24/7/365 Durch das Chat-Widget wichtig, wenn Sie laufen.

NVIDIA H200 GPU-Hosting bietet beschleunigte Rechenleistung für KI, große Sprachmodelle, und speicherintensive Anwendungen. Wählen Sie eine Serverkonfiguration entsprechend Ihrer Modellgröße und Arbeitslast.

H200-Server können Deep Learning unterstützen, Inferenz für große Modelle, Wissenschaftliches Rechnen, und andere kompatible GPU-beschleunigte Anwendungen. Die tatsächliche Leistung hängt von der Software- und Workload-Konfiguration ab.

Der GPU-Speicher speichert Modellgewichte und Arbeitsdaten. Größere Modelle, größere Chargen, und längere Kontexte erhöhen den Speicherbedarf, Schätzen Sie daher diese Anforderungen ein, bevor Sie einen Server auswählen.

Sie können kompatible GPU-fähige Frameworks mit einem geeigneten NVIDIA-Treiber und CUDA-Software-Stack verwenden. Überprüfen Sie vor der Installation die Framework-Version und die Anforderungen an das Bereitstellungsimage.

NEIN. Kleinere Modelle und Entwicklungsaufgaben passen möglicherweise zu anderen GPU-Optionen. Vergleichen Sie den Speicherbedarf, gemessene Leistung, und laufende Kosten, um geeignete Hardware auszuwählen.

Überprüfen Sie die verfügbare GPU-Konfiguration, System-RAM, CPU, Lagerung, Netzwerkzulage, und Abrechnungsbedingungen. Passen Sie diese Ressourcen an Ihre Anwendung und die erwartete Nutzung an.

Passen Sie den GPU-Speicher an Ihr Modell oder Ihre Rendering-Arbeitslast an, Lassen Sie dann genügend System-RAM zu, CPU, und Speicherung für Datenaufbereitungs- und Anwendungsprozesse. Testen Sie repräsentative Workloads vor der Skalierung.

GPU-beschleunigtes Rendering ist mit kompatibler Software möglich. Bestätigen Sie die Unterstützung für Ihr GPU-Modell, Treiberversion, Betriebssystem, und Anwendungslizenz vor der Bereitstellung.

Ja. Bewahren Sie unabhängige Kopien von Datensätzen auf, Code, Konfiguration, und Modellkontrollpunkte. GPU-Rechenressourcen ersetzen keinen Sicherungs- und Wiederherstellungsplan.

Bestätigen Sie die GPU-Verfügbarkeit, Treiber- und Framework-Kompatibilität, Speicherkapazität, Netzwerkbegriffe, und Abrechnungsbedingungen. Wählen Sie eine Konfiguration, die zu Ihrer Arbeitslast passt, und testen Sie sie vor dem Produktionseinsatz.